Мы готовы помочь Вам
Strix Halo против дискретной видеокарты: какой ПК выбрать для локальных языковых моделей
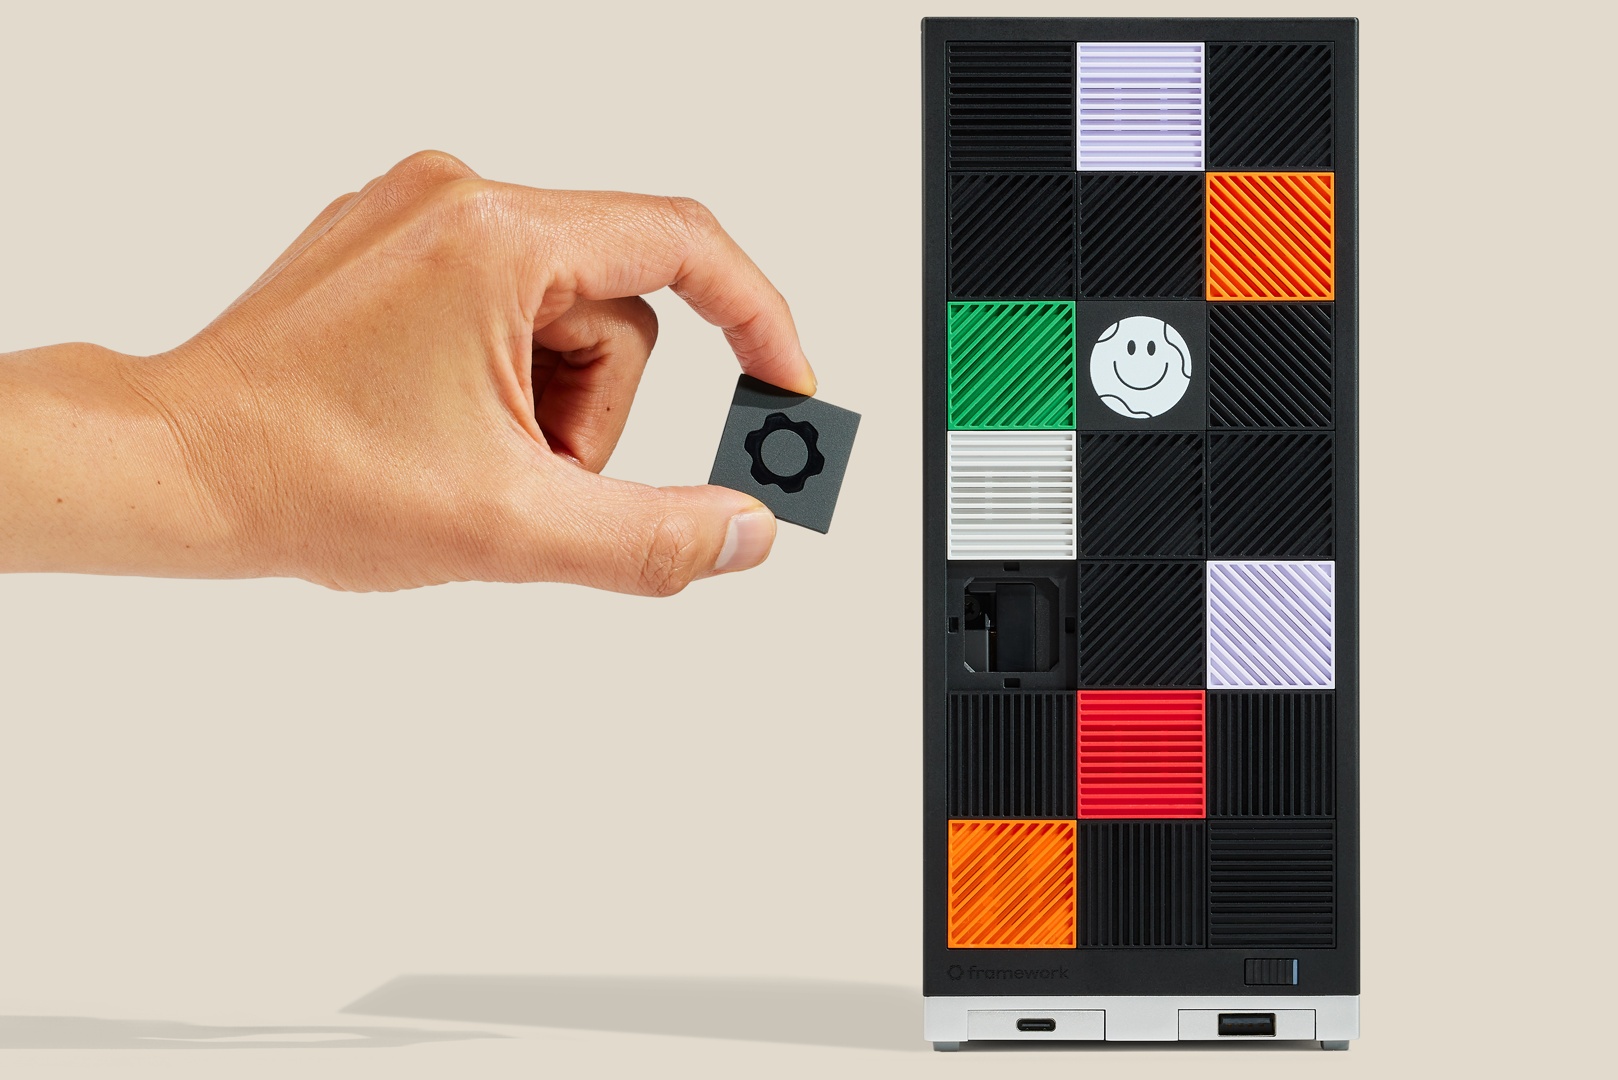
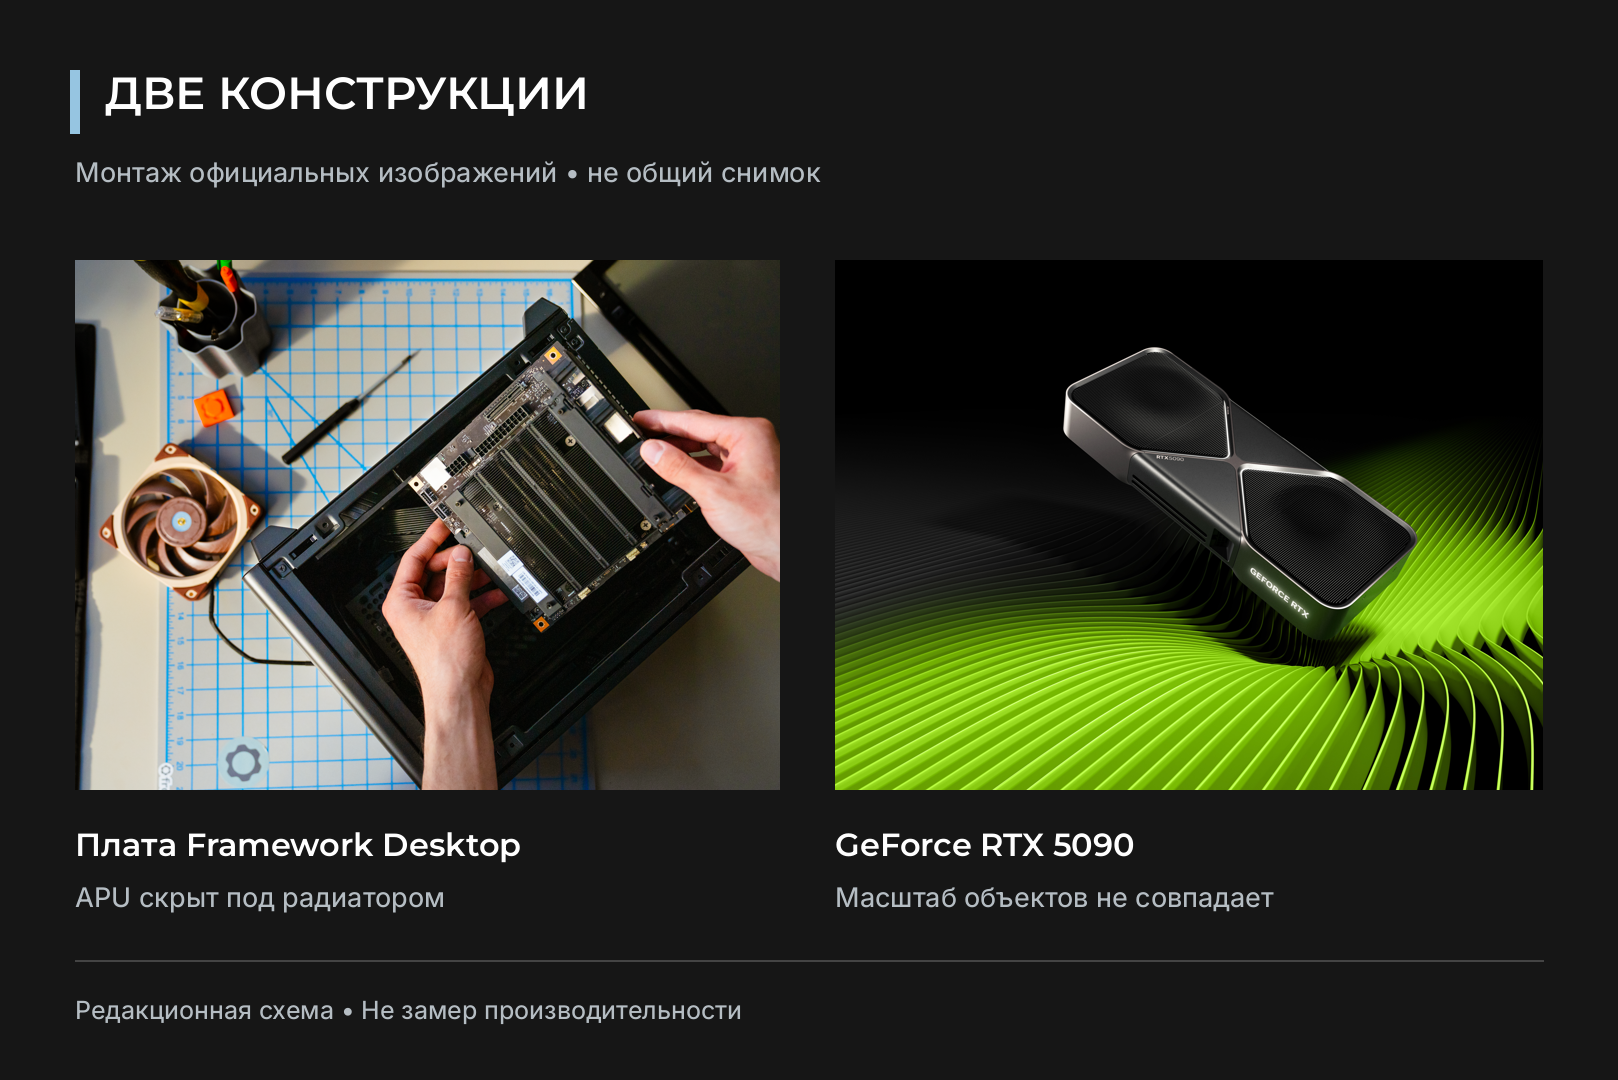
Для локальной нейросети важны два параметра: сколько памяти доступно модели и с какой скоростью эта память читается. Ryzen AI Max+ 395 (Strix Halo) выигрывает по первому: до 96 ГБ из 128 ГБ общей памяти отдаются графике. Дискретная видеокарта выигрывает по второму: у GeForce RTX 5090 пропускная способность памяти около 1792 ГБ/с против примерно 256 ГБ/с у Strix Halo.
От того, какой из двух параметров для вас важнее, и зависит выбор.
Сравнение в одной таблице
| Параметр | Ryzen AI Max+ 395, 128 ГБ | GeForce RTX 5090 |
|---|---|---|
| Память, доступная модели | до 96 ГБ (Windows) | 32 ГБ GDDR7 |
| Пропускная способность | около 256 ГБ/с (теория), около 215 ГБ/с под нагрузкой | около 1792 ГБ/с |
| Шина памяти | 256 бит | 512 бит |
| Вычислительный блок | Radeon 8060S, 40 блоков RDNA 3.5 | GPU GB202, 21 760 ядер CUDA |
| Модель 8B, генерация | 80-90 токенов/с | около 186 токенов/с |
| Апгрейд памяти | невозможен, память распаяна | заменой видеокарты |
Цифры скорости приведены по замерам Codersera, характеристики RTX 5090 по базе TechPowerUp.
Почему вообще возникает выбор
Языковая модель работает быстро, только когда все её веса лежат в памяти графического процессора. Если хоть часть весов не влезла и ушла в оперативную память, скорость падает в разы.
Обычная видеокарта ограничена своей VRAM. Даже у RTX 5090 это 32 ГБ, и модель 70B в 4 битах (около 40 ГБ для Llama 3.3 70B в формате Q4_K_M) в неё уже не помещается. Приходится ставить несколько видеокарт или выбирать профессиональную карту с большим объёмом памяти.
Strix Halo решает задачу иначе. У процессора и встроенной графики один физический пул LPDDR5X-8000. Через функцию Variable Graphics Memory в BIOS или AMD Software Adrenalin Edition графике можно выделить до 96 ГБ. В такой объём помещается, например, gpt-oss-120b в формате MXFP4: по данным AMD, ей нужно около 61 ГБ.
Если хотите прикинуть объём под свою модель, в статье «Сколько VRAM нужно, чтобы запустить Llama 70B и DeepSeek локально» мы разобрали расчёт по шагам.
Когда Strix Halo сильнее
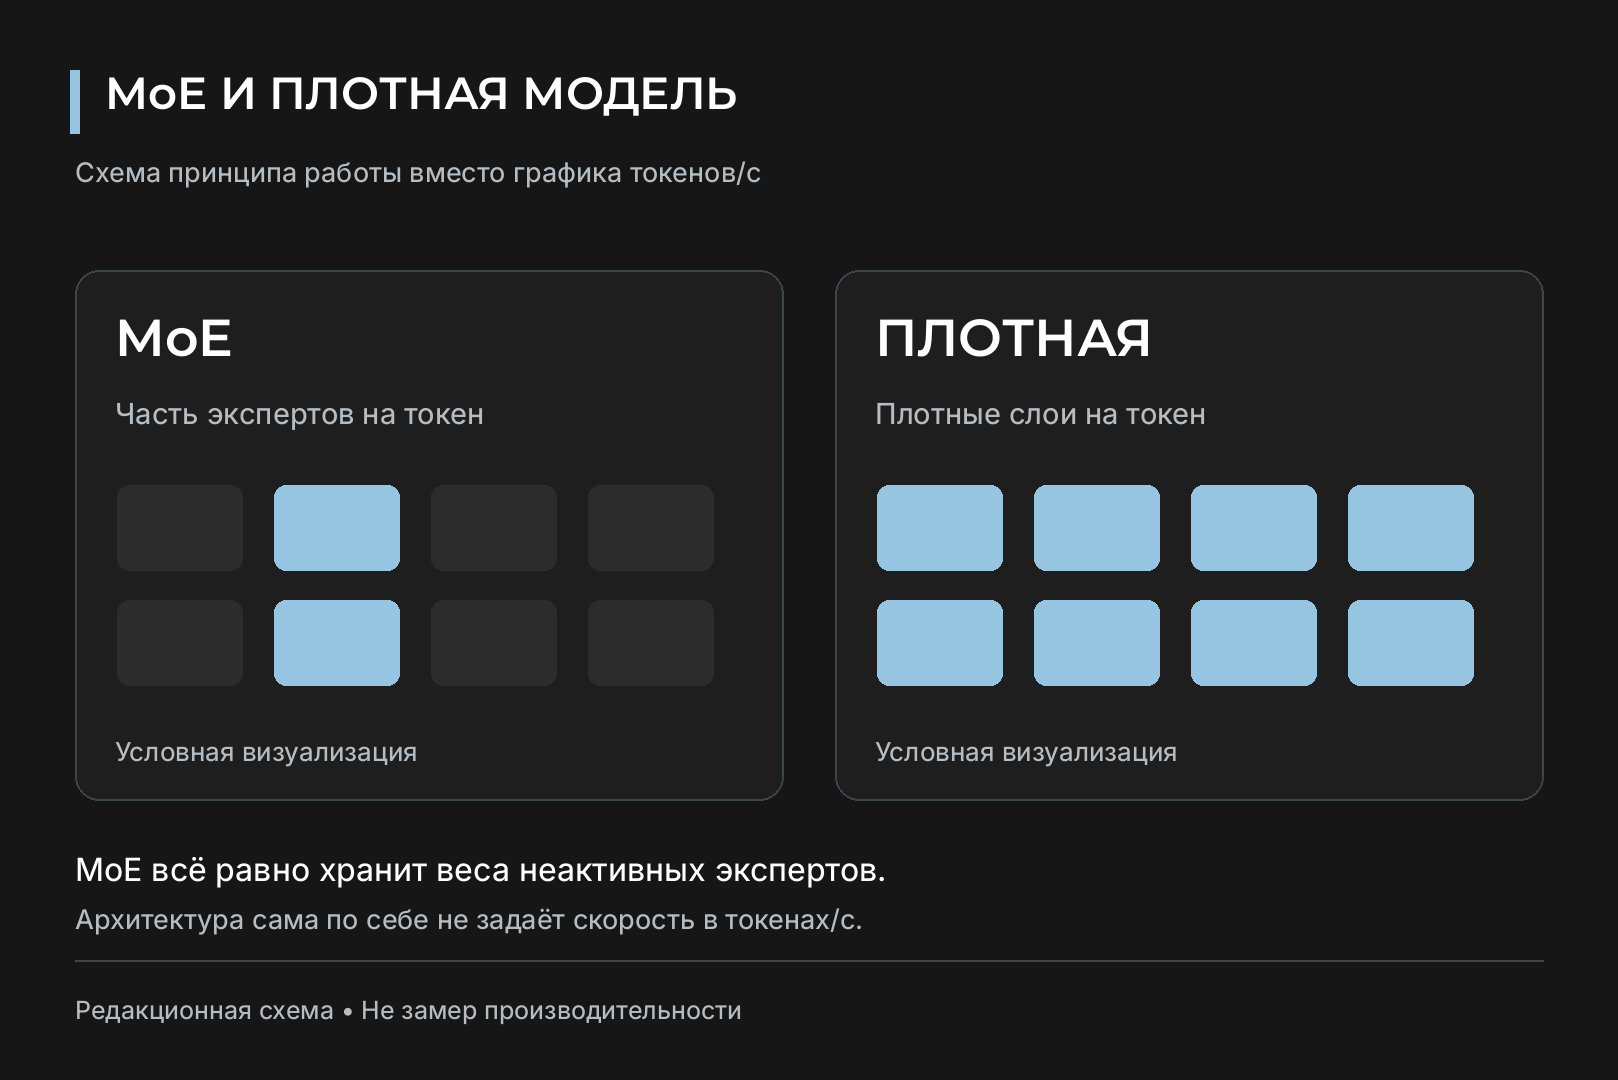
- MoE-модели на 100B и больше. В архитектуре Mixture of Experts на каждый токен работает лишь часть параметров. У Llama 4 Scout всего 109 миллиардов параметров, но активных 17 миллиардов. Модели нужно много памяти, но читается за один шаг немного, поэтому медленная память не губит скорость. По замерам Codersera gpt-oss-120b генерирует на Strix Halo около 55 токенов/с, а Qwen3-30B-A3B около 100 токенов/с.
- Компактность. Процессор, графика и память в одном чипе с потреблением до 120 Вт в зависимости от системы. Такой ПК занимает мало места и не требует мощного блока питания.
- Длинный контекст в памяти. AMD заявляет поддержку контекста до 256 тысяч токенов для Llama 4 Scout при включённых Flash Attention и Q8 KV-кэше: большой объём памяти позволяет держать и модель, и кэш контекста.
Когда видеокарта сильнее
- Модели до 30B. Если модель целиком помещается в VRAM видеокарты, видеокарта выигрывает по скорости: на модели 8B разница больше чем вдвое в пользу RTX 5090.
- Плотные модели 70B. На Strix Halo Llama 3.3 70B в 4 битах выдаёт около 4-6 токенов/с. Для чата и программирования этого мало.
- Обработка длинных промптов. Чтение промпта (prefill) нагружает вычислительные блоки, и 40 блоков встроенной графики уступают крупному дискретному GPU.
- Обучение, генерация изображений и игры. Для дообучения моделей стандартом остаётся экосистема CUDA. В играх Radeon 8060S тоже ограничена: в тесте PCWorld Cyberpunk 2077 в Full HD с трассировкой на ультра и FSR 2.1 выдал 48,85 FPS, в 3440 x 1440 уже 28,8 FPS.
Почему пропускная способность решает всё
Чтобы понять, откуда такая разница в скорости, полезно представить, что происходит при генерации ответа. Модель выдаёт текст по одному токену. На каждый токен она проходит через все свои слои, и веса этих слоёв нужно прочитать из памяти. Для плотной модели это все параметры целиком, для MoE только активные эксперты.
Отсюда простая оценка сверху: скорость генерации не может превысить пропускную способность памяти, делённую на объём читаемых за шаг данных. Плотная Llama 3.3 70B в 4 битах это около 40 ГБ. При реальных 215 ГБ/с чип физически не прочитает эти данные больше пяти раз в секунду, и замеры в 4-6 токенов/с ровно это и показывают. У gpt-oss-120b за шаг читается лишь небольшая доля весов, поэтому та же память выдаёт десятки токенов в секунду.
Из этого следует практический вывод. Для Strix Halo имеет смысл выбирать модели с архитектурой MoE, а плотные модели держать в пределах 30B, если важна скорость. Для дискретной видеокарты логика обратная: скорость высокая, но предел задаёт объём VRAM.
Как настроить память под модель
На Windows объём памяти для графики выбирается в AMD Software Adrenalin Edition: режим Variable Graphics Memory переключается на пользовательский, и на системе со 128 ГБ доступно до 96 ГБ. Оставшаяся часть остаётся системе и программам. Если модель занимает 61 ГБ, как gpt-oss-120b, запаса в 96 ГБ хватит и на весы, и на кэш контекста.
На Linux подход другой. В BIOS объём буфера кадров для графики ставят минимальным, а доступную графике память расширяют параметрами ядра. По описанию Codersera, так графика может адресовать около 105-107 ГБ, то есть больше, чем позволяет Windows. Это полезно для самых крупных MoE-моделей, где каждый гигабайт на счету.
Для самих моделей удобно использовать формат GGUF: его понимают и LM Studio, и llama.cpp. При выборе квантизации помните, что 4 бита сейчас разумный компромисс между качеством и объёмом, а 8 бит удваивает требования к памяти.
Три типичных сценария
- Разработчик с ИИ-ассистентом для кода. Ему нужны быстрые ответы, а модели чаще всего укладываются в 30B. Здесь выигрывает ПК с мощной видеокартой: ответ приходит быстрее, длинные файлы в промпте обрабатываются без долгого ожидания.
- Аналитик, который хочет крупную модель без облака. Документы нельзя отправлять во внешние сервисы, а качество ответов малых моделей не устраивает. MoE-модель уровня gpt-oss-120b на Strix Halo со 128 ГБ даёт и объём, и приемлемую скорость в одном компактном корпусе.
- Исследователь, который дообучает модели. Ему нужны CUDA, большие объёмы VRAM и высокая вычислительная мощность. Это задача для рабочей станции с одной или несколькими дискретными видеокартами NVIDIA.
Что проверить перед покупкой ПК на Strix Halo
- Объём памяти. Берите 128 ГБ, если планируете модели крупнее 30B: память распаяна, и добавить её потом не получится.
- Охлаждение. Производительность чипа сильно зависит от корпуса и системы охлаждения конкретного устройства.
- Драйвер. Поддержка моделей до 128B на Windows появилась в Adrenalin 25.8.1, нужна эта версия или новее.
- Программы. Основной путь сейчас LM Studio и llama.cpp с бэкендом Vulkan. ROCm для этого чипа ещё развивается.
- Внешняя видеокарта. Если хочется оставить возможность подключить eGPU, проверьте наличие USB4 или OCuLink в конкретной модели.
Рекомендуем
Частые вопросы Мы подготовили ответы.
-
Запустится ли на Ryzen AI Max+ 395 модель 70B?
Да, Llama 3.3 70B в 4 битах занимает около 40 ГБ и помещается в память. Но скорость около 4-6 токенов/с делает диалог медленным.
-
Нужен ли NPU для языковых моделей?
NPU XDNA 2 даёт 50 TOPS, однако LM Studio и llama.cpp с Vulkan считают модели на графике. Заявленные 126 TOPS это сумма по CPU, GPU и NPU.
-
Что выбрать для программирования с ИИ-ассистентом?
Если вам хватает модели до 30B, ПК с мощной видеокартой даст более быстрые ответы. Если нужна крупная MoE-модель в одном устройстве, Strix Halo со 128 ГБ решает эту задачу.
Если вы решили, что вам нужна система с дискретной видеокартой под нейросети, подходящую конфигурацию можно подобрать в каталоге HYPERPC.