Мы готовы помочь Вам
AMD Helios: производство и пропускная способность сети
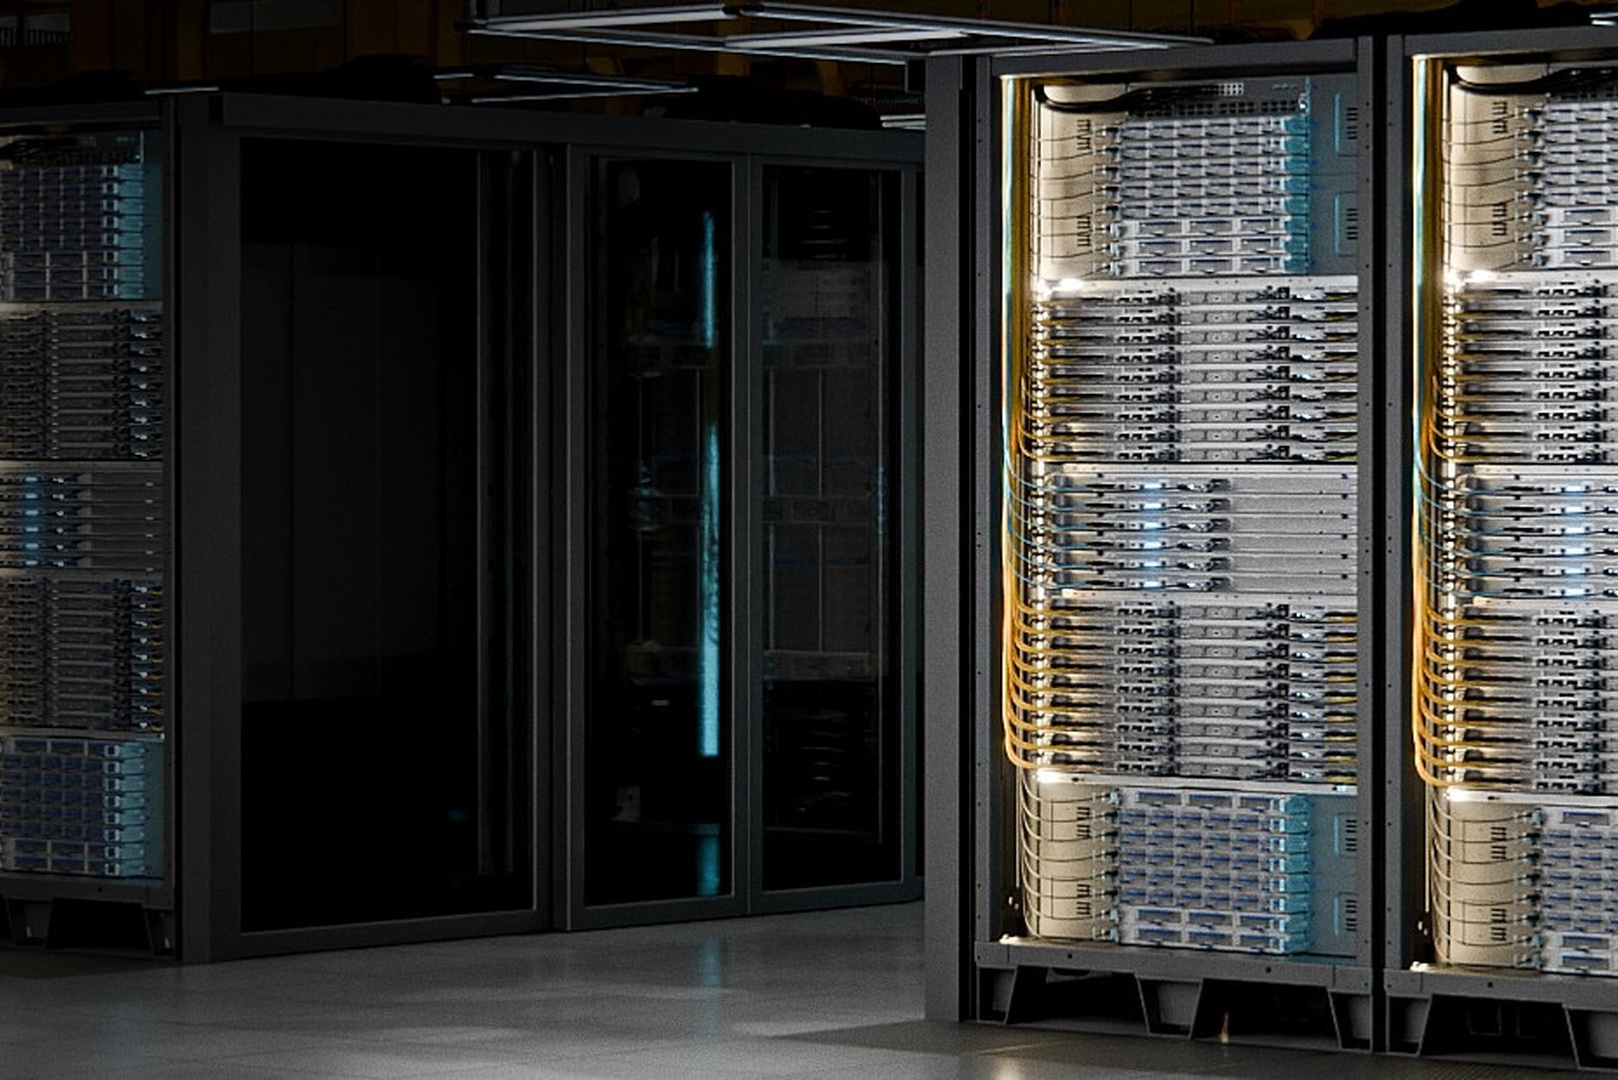
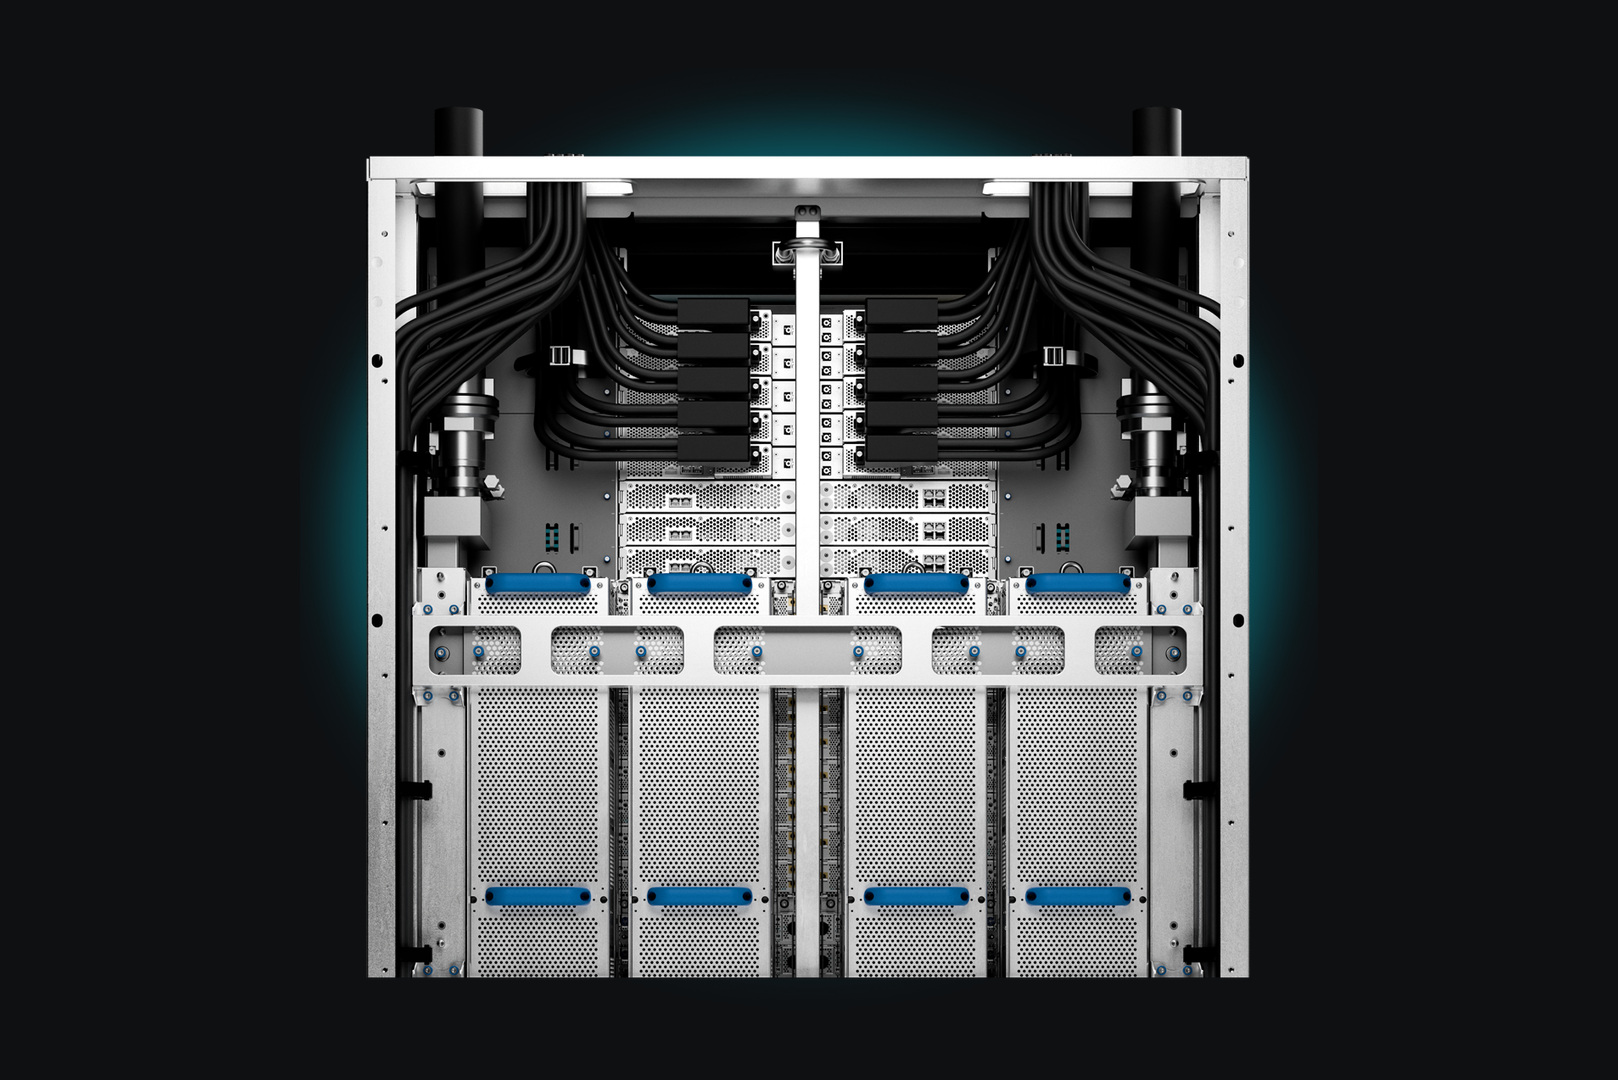
Helios — первая полностью стоечная ИИ-система AMD, и её главная особенность не в количестве ускорителей, а в том, что вся сеть внутри стойки построена на Ethernet и открытых стандартах вместо проприетарного интерконнекта. Для рынка, где стоечные ИИ-платформы до сих пор означали закрытые линки одного поставщика, это принципиальный сдвиг.
Ниже — что именно AMD показала, как читать заявленные цифры пропускной способности, чем scale-up отличается от scale-out и какие выводы из этой архитектуры применимы в инфраструктуре куда меньшего масштаба, чем стойка на 72 ускорителя.
Что такое Helios и чем он отличается от обычного сервера
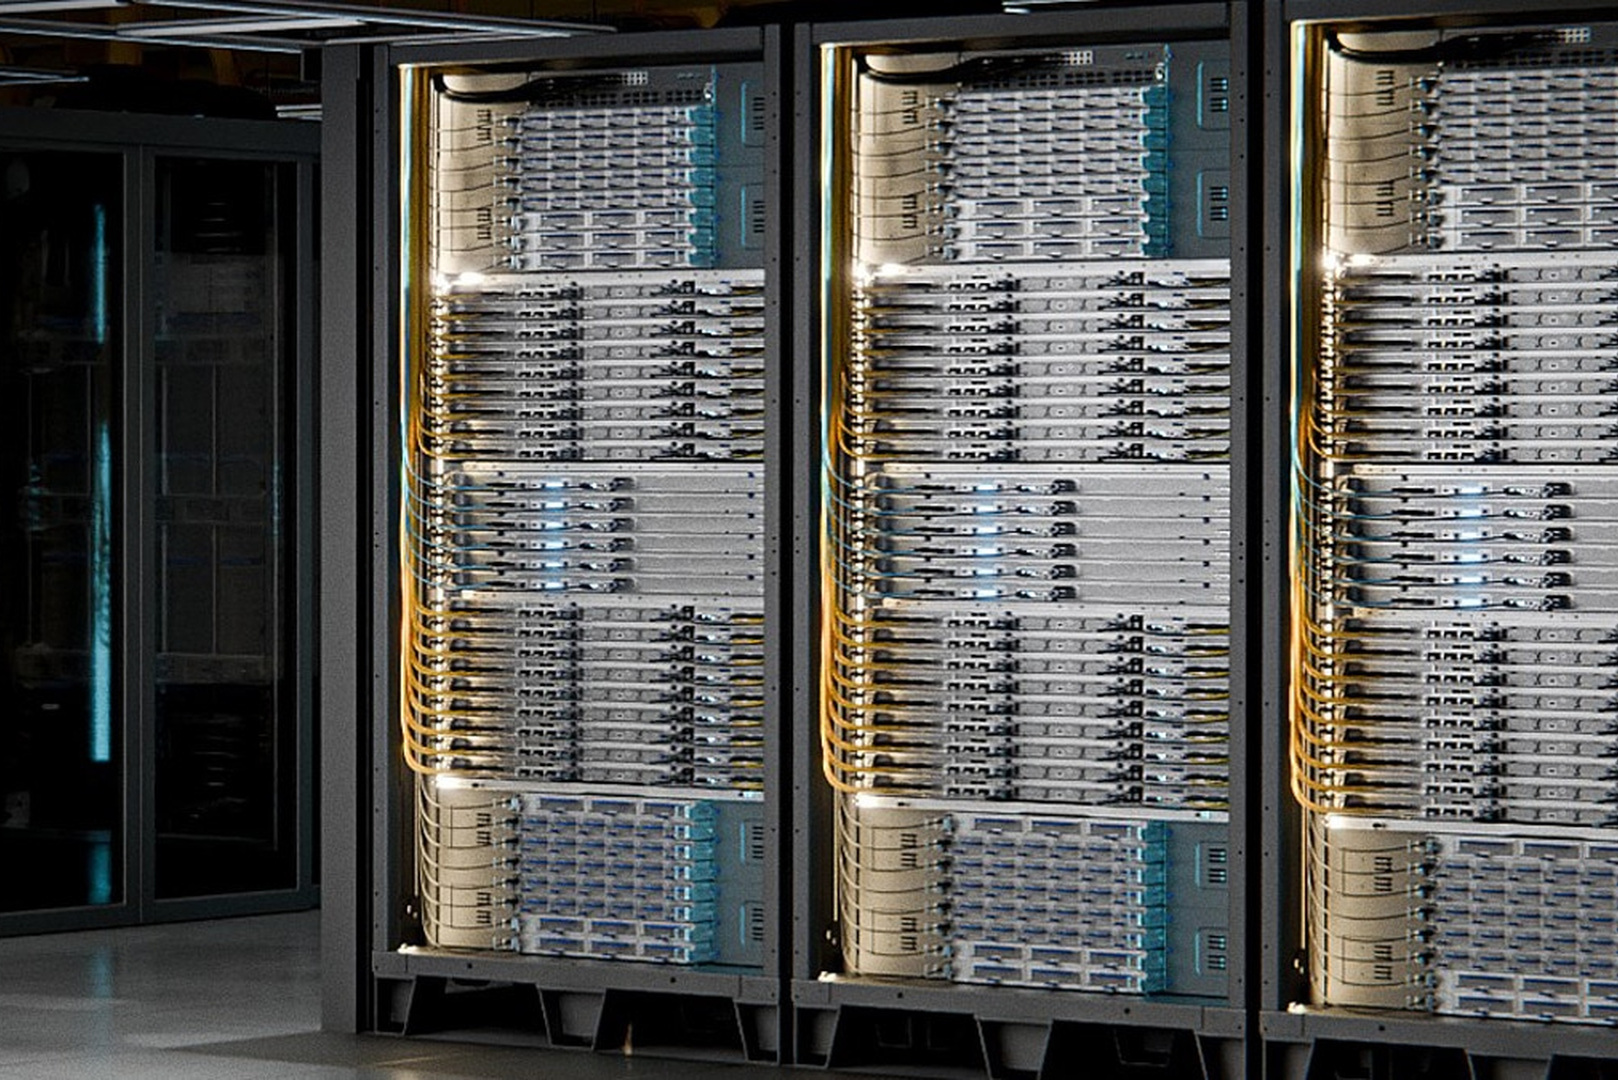
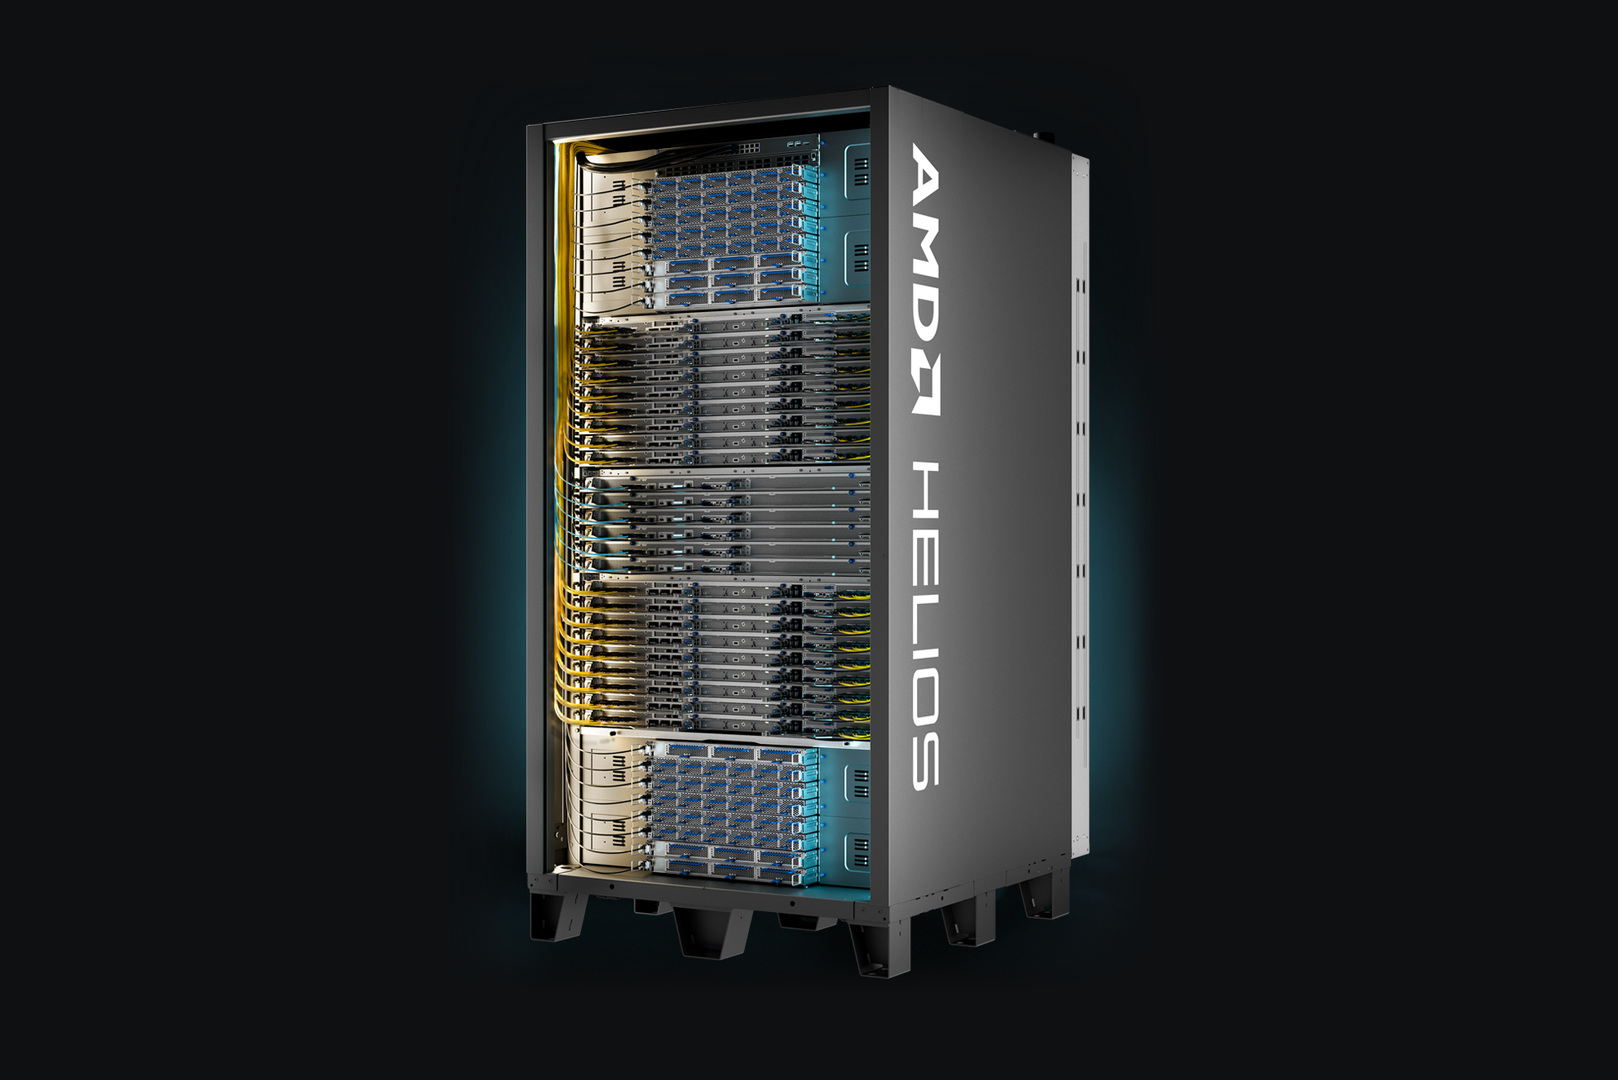
Helios — это не сервер, а стойка, спроектированная как единое вычислительное устройство. Внутри 72 ускорителя Instinct MI455X объединены в один scale-up домен: с точки зрения задачи это одна большая машина с общим пулом памяти, а не 72 отдельных сервера, соединённых сетью.
Разница между этими подходами определяет, какие задачи вообще решаемы:
- Отдельные серверы, соединённые сетью, хороши, когда задача делится на независимые части: инференс множества запросов, пакетная обработка, рендер.
- Стоечный домен с общей памятью нужен, когда модель не влезает в память одного узла и её приходится распределять. Тогда скорость обмена между ускорителями становится таким же ресурсом, как и сами вычисления.
- Гибридные сценарии — обучение на стойке, инференс на отдельных узлах — самый частый вариант в реальной эксплуатации.
В основе платформы, помимо ускорителей, лежат процессоры EPYC шестого поколения, а само семейство ускорителей MI400 включает три модели: MI430X, MI440X и MI455X, представленные на CES 2026.
Ключевые цифры
| Параметр | Значение |
|---|---|
| Ускорителей в стойке | 72 Instinct MI455X |
| Объединённая память | 31 ТБ HBM4 |
| Пиковая производительность FP4 | 2,9 экзафлопс |
| Пропускная способность scale-up | 260 ТБ/с |
| Scale-out на адаптер | 800 Гбит/с (Pensando Vulcano) |
| Интерфейс адаптера | PCIe Gen 6, форм-фактор OCP |
| Стандарт стойки | OCP Open Rack Wide (ORW) |
| Интерконнект ускорителей | UALink |
| Scale-out фабрика | Ultra Ethernet (UEC) |
| Процессоры | EPYC 6-го поколения |
Цифру 260 ТБ/с стоит читать правильно: это суммарная пропускная способность внутреннего домена, а не скорость одного канала. Она характеризует, насколько быстро 72 ускорителя обмениваются данными между собой, и именно этот параметр ограничивает масштабирование крупных моделей.
Почему Ethernet вместо проприетарного интерконнекта
Ключевое решение AMD: каждая фабрика в стойке, от фронтенд-сети до связи GPU с GPU, работает на Ethernet и открытых стандартах. Причин для такого выбора три, и все они практические.
- Совместимость с существующей инфраструктурой. Ethernet — то, что уже развёрнуто в любом дата-центре, с готовыми инструментами мониторинга, диагностики и персоналом, который умеет с ним работать.
- Отсутствие привязки к поставщику. Проприетарный интерконнект означает, что коммутаторы, кабели и адаптеры покупаются у одного вендора по его цене и в его сроки.
- Скорость развития стандарта. Ethernet двигают десятки компаний одновременно, и переход с 400 на 800 Гбит/с в этой экосистеме происходит без замены архитектуры.
Обратная сторона тоже есть: исторически проприетарные интерконнекты выигрывали по задержкам на коллективных операциях, и именно поэтому доминировали в ИИ-кластерах. Консорциумы UALink и Ultra Ethernet созданы, чтобы закрыть этот разрыв стандартными средствами. Helios — первая масштабная проверка того, насколько это удалось.
Scale-up и scale-out: почему это разные цифры
Путаница между этими понятиями — главная причина неверной трактовки характеристик ИИ-платформ. Различие простое.
Scale-up — это связь внутри одного домена, между ускорителями одной стойки. Здесь важны предельная пропускная способность и минимальная задержка, потому что по этому каналу идёт обмен весами и активациями при распределённых вычислениях. В Helios за это отвечает UALink, а суммарная цифра составляет 260 ТБ/с.
Scale-out — это связь между стойками, то есть собственно сеть дата-центра. Здесь на первом месте стандартность, маршрутизируемость и управляемость. За это отвечает Ultra Ethernet и адаптеры Pensando: 400 Гбит/с у Pollara и 800 Гбит/с у готовящегося Vulcano.
Практический вывод для проектирования: увеличение количества ускорителей в кластере без соответствующего роста scale-out полосы даёт всё меньшую отдачу. На каком-то этапе узким местом становится не вычисление, а обмен данными, и добавленные ускорители простаивают в ожидании синхронизации.
Что означают UALink, Ultra Ethernet и OCP ORW
Три аббревиатуры, которые определяют открытость платформы.
- UALink (Ultra Accelerator Link) — открытый стандарт связи ускорителей между собой внутри домена. Прямой ответ на проприетарные решения для scale-up.
- UEC (Ultra Ethernet Consortium) — развитие Ethernet под задачи ИИ и HPC: управление перегрузками, многопутевая передача, сокращение задержек на коллективных операциях.
- OCP Open Rack Wide (ORW) — открытая спецификация самой стойки: габариты, питание, охлаждение. Означает, что стойку и её компоненты можно закупать у разных производителей.
Именно поэтому Helios доступен не как единственный продукт AMD, а через OEM и ODM партнёров: например, Supermicro выпускает стойку на 72 ускорителя MI455X, а в марте 2026 года AMD объявила о сотрудничестве с Celestica. Развёртывание платформы идёт в течение 2026 года.
Адаптеры Pollara 400G и Vulcano 800G
Сетевая часть платформы строится на адаптерах Pensando, и их характеристики важнее, чем кажется на первый взгляд.
- Pensando Pollara 400G — текущее поколение, 400 Гбит/с, работает с существующей инфраструктурой Ultra Ethernet.
- Pensando Vulcano 800G — готовящееся поколение: 800 Гбит/с на scale-out, интерфейс PCIe Gen 6, форм-фактор OCP и поддержка UALink для прямой связи с процессорами и ускорителями.
Пункт про PCIe Gen 6 стоит отметить отдельно. Адаптер на 800 Гбит/с физически не может раскрыться на более медленной шине: одного слота PCIe Gen 5 x16 для такой полосы уже недостаточно. Это тот случай, когда сетевая карта диктует требования к платформе целиком, а не наоборот.
Что из этого применимо в меньшем масштабе
Стойка на 72 ускорителя — задача единиц компаний. Но принципы, на которых она построена, работают и на инфраструктуре из одного-двух серверов, и игнорирование их стоит дорого.
- Сеть проектируется вместе с вычислениями, а не после. Классическая ошибка: закупить серверы с ускорителями, а сетевую часть оставить на потом. В результате узлы есть, а обучение на них распределить невозможно.
- Пропускная способность интерконнекта важнее количества карт, когда модель не влезает в память одного ускорителя. Две карты с быстрой связью между собой часто дают больше, чем четыре с медленной.
- Объём памяти определяет, что вообще запустится. 31 ТБ в Helios решают ту же задачу, что 48 или 96 ГБ в одной профессиональной карте на другом масштабе: модель либо помещается, либо нет. Сколько нужно под конкретные модели, разобрано в материале сколько VRAM нужно для локального запуска Llama 70B и DeepSeek.
- Шина PCIe становится ограничителем. Быстрые адаптеры и ускорители требуют актуальной версии PCIe и достаточного количества линий, и это проверяется на этапе выбора платформы.
- Открытые стандарты снижают стоимость владения. Возможность закупать компоненты у разных поставщиков влияет на цену и сроки сильнее, чем разница в характеристиках одного узла.
Как выбирать платформу под конкретную задачу, подробно разобрано в руководстве как выбрать сервер для ИИ в 2026 году, а конфигурации под обучение и инференс есть в разделах серверов для машинного обучения и серверов с GPU.
Когда сеть становится узким местом
Признаки, по которым видно, что упор в инфраструктуре не в вычислениях, а в обмене данными:
- Загрузка ускорителей заметно ниже 90 процентов при работающем обучении, а профилировщик показывает ожидание на операциях синхронизации.
- Масштабирование нелинейно: удвоение количества узлов даёт прирост скорости заметно меньше полутора раз.
- Время итерации растёт при увеличении размера модели быстрее, чем объём вычислений.
- Задержки на коллективных операциях занимают ощутимую долю времени шага.
В этих случаях добавление ускорителей не помогает: нужно увеличивать полосу и уменьшать задержки, то есть работать с сетевой частью. Именно эту проблему и решает архитектура вида Helios, только на своём масштабе.
Что делать сейчас
Если вы проектируете или расширяете ИИ-инфраструктуру, из анонса Helios есть три практических следствия:
- Закладывать открытые стандарты там, где есть выбор: это снижает риск привязки к одному поставщику на весь срок жизни инфраструктуры.
- Считать сеть в бюджете проекта отдельной строкой, сопоставимой по значимости с ускорителями.
- Проверять версию PCIe и количество линий на платформе до закупки адаптеров: карта на 800 Гбит/с на старой шине не даст заявленной полосы.
Подобрать конфигурацию под конкретную модель и объём данных можно на базе серверов и рабочих станций.
Рекомендуем
Частые вопросы
-
Что такое AMD Helios?
Это первая стоечная ИИ-система AMD, в которой 72 ускорителя Instinct MI455X объединены в единый вычислительный домен с 31 ТБ памяти HBM4 и пиковой производительностью 2,9 экзафлопс в формате FP4. Ключевая особенность в том, что вся сеть внутри стойки построена на Ethernet и открытых стандартах.
-
Какая пропускная способность сети у Helios?
Внутренний scale-up домен обеспечивает 260 ТБ/с суммарной пропускной способности между ускорителями через UALink. Для связи между стойками используется Ultra Ethernet с адаптерами Pensando: 400 Гбит/с у Pollara и 800 Гбит/с у готовящегося Vulcano.
-
Чем scale-up отличается от scale-out?
Scale-up — это связь между ускорителями внутри одного домена, где критичны предельная полоса и минимальная задержка. Scale-out — связь между стойками, то есть сеть дата-центра, где на первом месте стандартность и управляемость. Это разные фабрики с разными требованиями, и путать их цифры нельзя.
-
Почему AMD выбрала Ethernet, а не проприетарный интерконнект?
По трём причинам: Ethernet уже развёрнут в дата-центрах вместе с инструментами и компетенциями, открытый стандарт снимает привязку к одному поставщику коммутаторов и кабелей, а развитие стандарта идёт силами десятков компаний. Задержки на коллективных операциях закрываются за счёт UALink и Ultra Ethernet.
-
Что такое UALink и Ultra Ethernet?
UALink — открытый стандарт связи ускорителей между собой внутри домена, альтернатива проприетарным решениям для scale-up. Ultra Ethernet — развитие Ethernet под задачи ИИ и HPC с управлением перегрузками, многопутевой передачей и снижением задержек на коллективных операциях.
-
Когда Helios станет доступен?
Развёртывание идёт в течение 2026 года через OEM и ODM партнёров. Supermicro выпускает стойку на 72 ускорителя MI455X, а в марте 2026 года AMD объявила о сотрудничестве с Celestica.
-
Какие ускорители входят в семейство MI400?
Три модели, представленные на CES 2026: MI430X, MI440X и MI455X. Helios построен на MI455X, остальные закрывают другие профили нагрузки. В составе платформы также используются процессоры EPYC шестого поколения.
-
Зачем сетевому адаптеру PCIe Gen 6?
Потому что адаптер на 800 Гбит/с не раскрывается на более медленной шине: полосы одного слота PCIe Gen 5 x16 для такой скорости уже недостаточно. Это означает, что требования к версии PCIe и количеству линий нужно проверять на платформе до закупки адаптеров.
-
Как понять, что в моём кластере узкое место в сети, а не в вычислениях?
По четырём признакам: загрузка ускорителей устойчиво ниже 90 процентов при работающем обучении, нелинейное масштабирование при добавлении узлов, рост времени итерации быстрее роста объёма вычислений и заметная доля времени шага, уходящая на коллективные операции.
-
Что из архитектуры Helios применимо на одном-двух серверах?
Три принципа: сеть проектируется вместе с вычислениями, а не после них; при распределённых задачах полоса интерконнекта важнее количества карт; версия PCIe и количество линий на платформе проверяются до закупки адаптеров и ускорителей.