Мы готовы помочь Вам
Генерация картинок нейросетью на домашнем ПК: что потянет ваша видеокарта
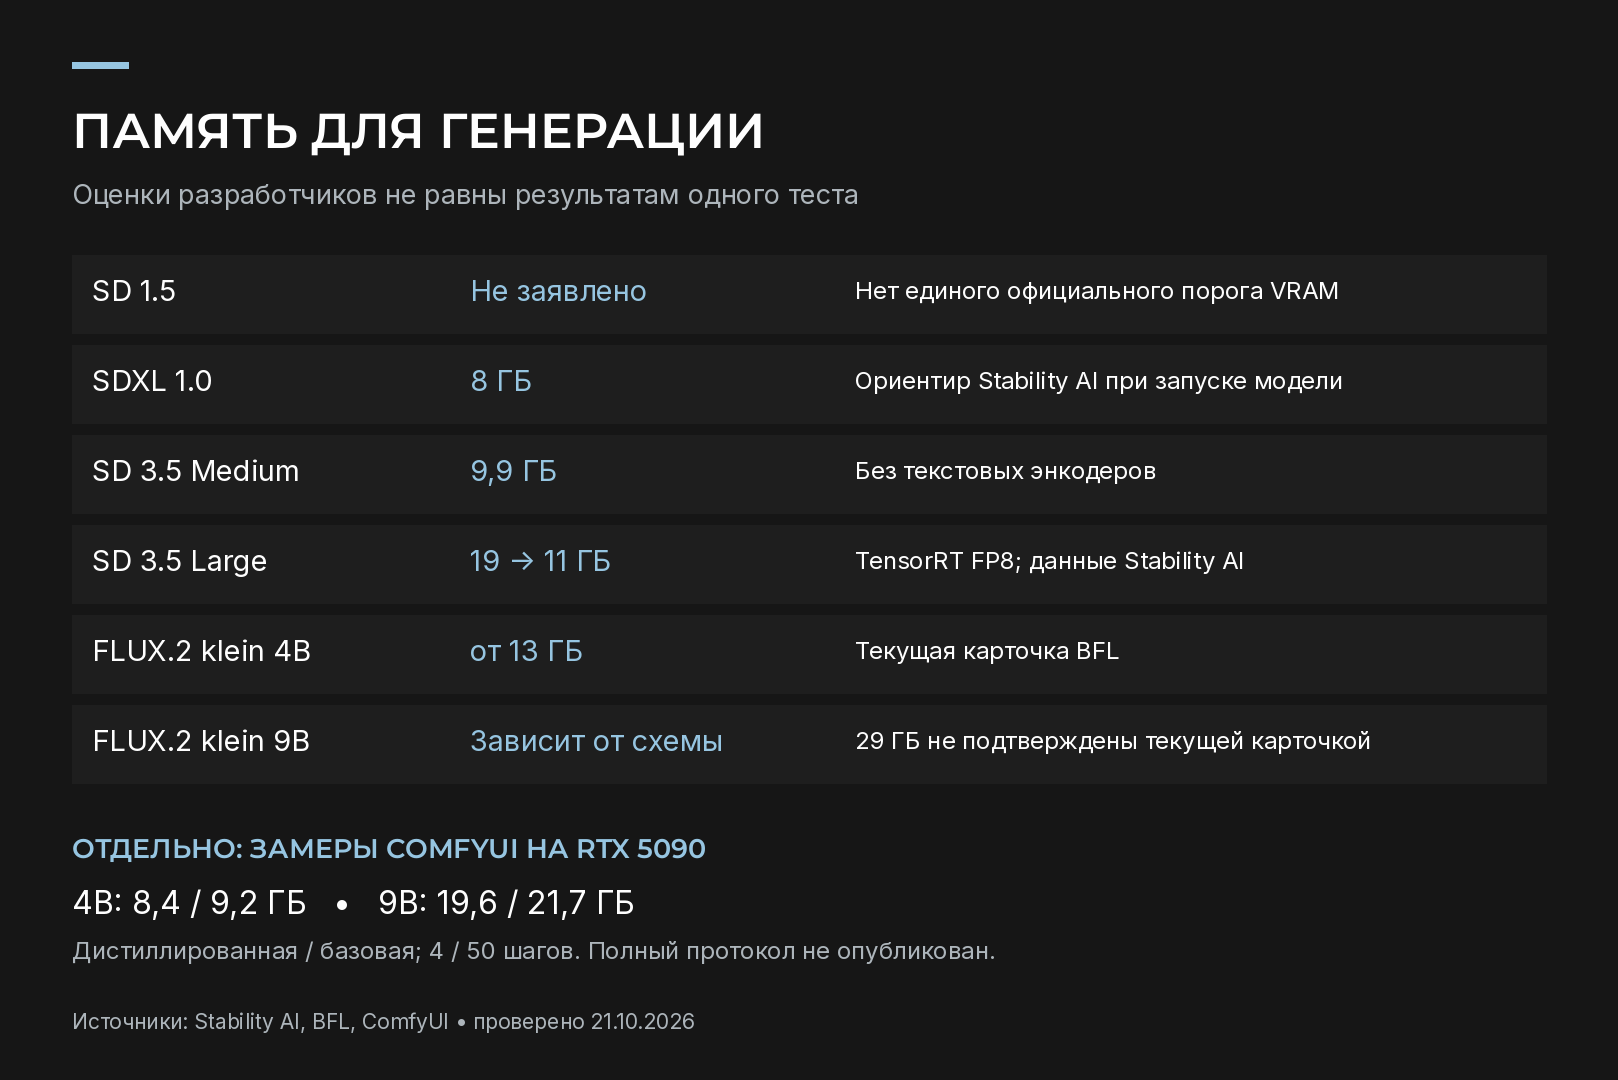
Объём видеопамяти определяет, какие модели генерации изображений вы сможете запустить локально. По данным Stability AI и Black Forest Labs, на 8 ГБ уверенно работают SD 1.5 и SDXL, на 16 ГБ помещаются SD 3.5 Medium и FLUX.2 [klein] 4B, а для SD 3.5 Large и FLUX.2 [klein] 9B в полном формате нужно от 18 до 29 ГБ. Разберём по ступеням, начиная с той карты, что уже стоит в вашем компьютере.
Сначала узнайте, сколько у вас памяти
Объём VRAM виден без сторонних программ. В Windows откройте Диспетчер задач, перейдите на вкладку «Производительность» и выберите «Графический процессор». Строка «Выделенная память графического процессора» и есть видеопамять. На картах NVIDIA ту же цифру выдаст команда nvidia-smi.
Строка «Общая память графического процессора» ниже это часть оперативной памяти, которую система может отдать видеокарте. Когда во время генерации растёт именно она, программа не уместилась в VRAM и переносит данные в RAM. Работать будет, но медленнее, иногда в разы.
8 ГБ: Stable Diffusion 1.5 и SDXL
Это входная ступень, на которой можно спокойно освоить локальную генерацию.
SD 1.5 самая компактная из популярных моделей: 0,9 млрд параметров, обучена на изображениях 512 × 512. Для неё 8 ГБ это запас, а не предел.
SDXL 1.0 крупнее: базовая модель на 3,5 млрд параметров, вместе с refiner связка достигает 6,6 млрд, родное разрешение 1024 × 1024. Stability AI при выходе модели указывала, что она должна эффективно работать на потребительских видеокартах с 8 ГБ. На практике это значит: одна картинка в базовом размере без дополнительных модулей. Если добавить ControlNet или поднять разрешение, восьми гигабайт станет тесно.
К этой ступени относится, например, GeForce RTX 5060 с 8 ГБ GDDR7 и вариант RTX 5060 Ti на 8 ГБ.
12 ГБ: SDXL с запасом и SD 3.5 Large в FP8
Двенадцать гигабайт снимают большую часть ограничений SDXL: можно подключать модули управления композицией и увеличивать кадр.
Здесь же открывается вариант с SD 3.5 Large. Сама модель (8,1 млрд параметров) в базовом виде занимает больше 18 ГБ. NVIDIA вместе со Stability AI выпустили версию, сжатую до FP8 и оптимизированную через TensorRT: по их данным, расход памяти падает на 40%, до 11 ГБ, а скорость растёт в 2,3 раза по сравнению с BF16 в PyTorch. Условие одно: FP8 поддерживают видеокарты RTX 40 и новее. На 12-гигабайтной карте вроде RTX 5070 такая версия помещается впритык.
16 ГБ: рабочий объём для актуальных моделей
Если вы хотите не просто попробовать, а регулярно работать с моделями последних двух лет, ориентир это 16 ГБ. На этот объём рассчитаны GeForce RTX 5060 Ti 16 ГБ, RTX 5070 Ti и RTX 5080.
SD 3.5 Medium (2,5 млрд параметров, разрешение от 0,25 до 2 Мп) по данным Stability AI требует 9,9 ГБ, но это без текстовых энкодеров. В SD 3.5 их три: два CLIP и T5-XXL, и они тоже занимают место. С 16 ГБ схема работает без постоянной выгрузки.
FLUX.2 [klein] 4B вышла 15 января 2026 года. В карточке на Hugging Face разработчик пишет, что модели нужно около 13 ГБ VRAM, и называет подходящими карты уровня RTX 3090 и RTX 4070 и выше. Модель умеет и генерировать по тексту, и редактировать изображения по нескольким референсам. Лицензия Apache 2.0 разрешает коммерческое использование.
24-32 ГБ: тяжёлые модели без компромиссов
Сюда попадают SD 3.5 Large в исходном формате (больше 18 ГБ) и FLUX.2 [klein] 9B. Для последней карточка модели указывает около 29 ГБ и видеокарты от RTX 4090 и выше. Текстовую часть у неё обрабатывает отдельная модель Qwen3 на 8 млрд параметров, отсюда и высокий расход. Учтите лицензию: версия 9B только для некоммерческого использования.
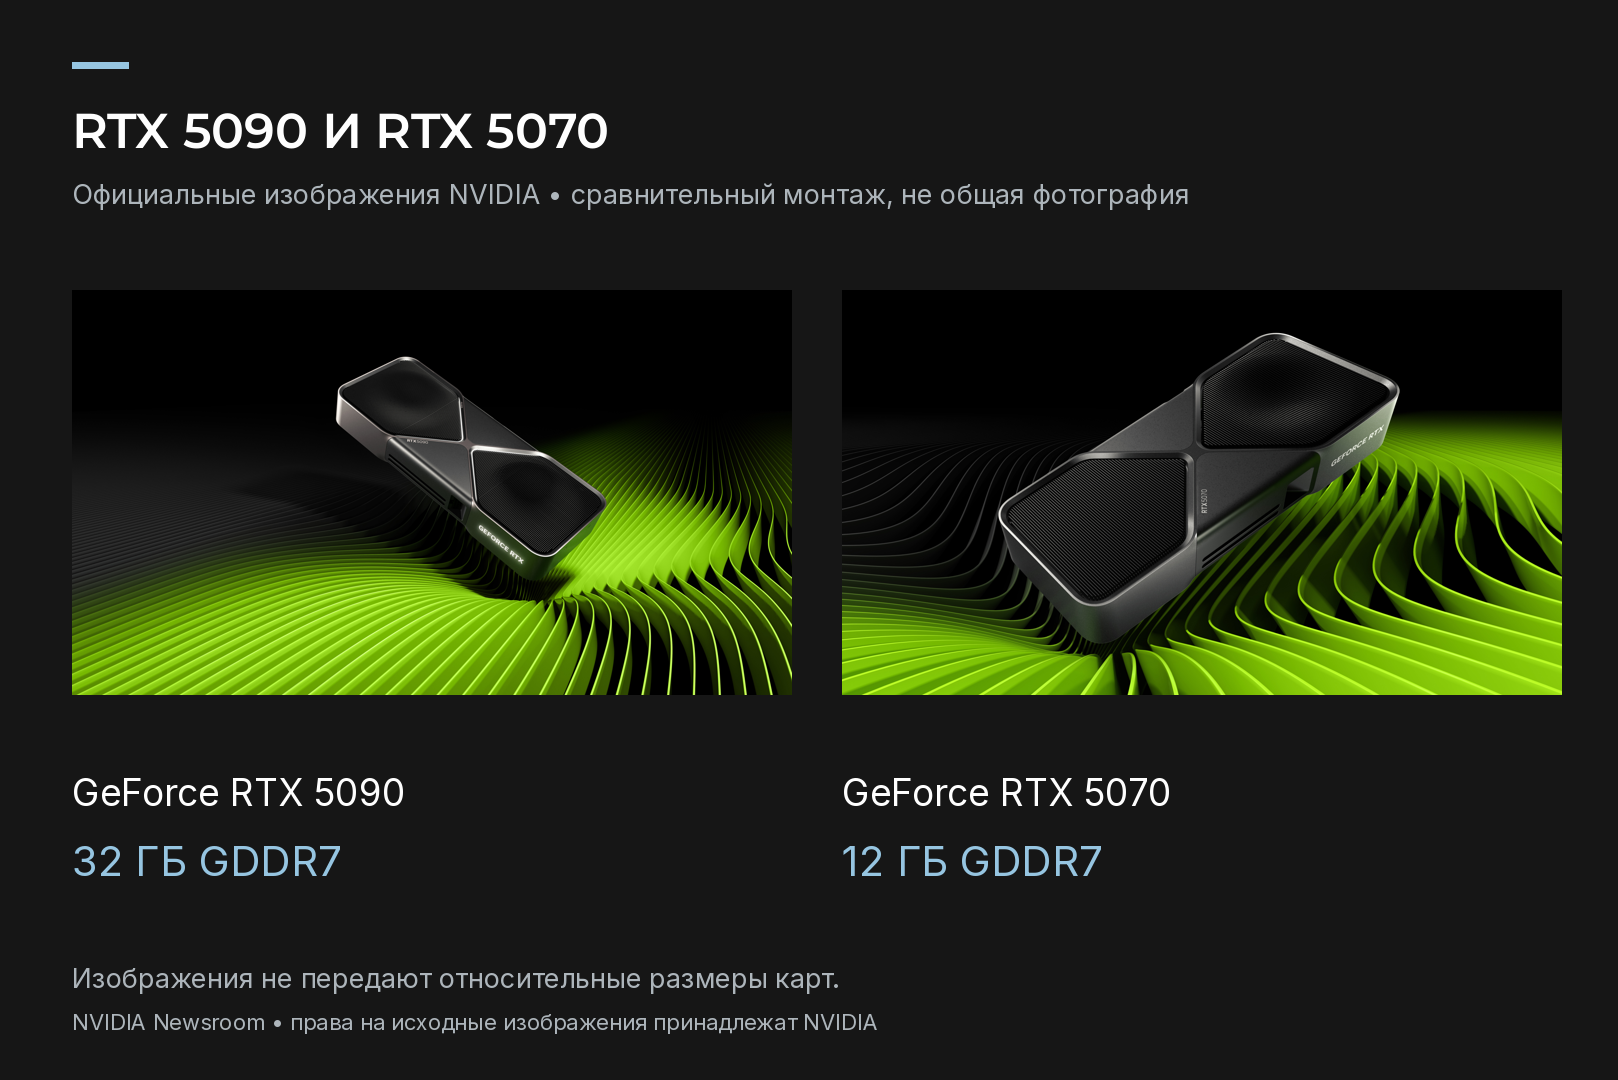
Из актуальной линейки NVIDIA под эту ступень подходит GeForce RTX 5090 с 32 ГБ GDDR7. Карты прошлых поколений RTX 4090 и RTX 3090 с 24 ГБ тоже справятся с частью задач, если уже есть в системе, но у RTX 3090 нет аппаратной поддержки FP8, которую NVIDIA заявляет начиная с RTX 40.
Почему цифры у разных источников не совпадают
Для FLUX.2 [klein] встречаются заметно разные значения. Карточки моделей дают около 13 ГБ для 4B и около 29 ГБ для 9B. Команда ComfyUI в своём блоге опубликовала замеры на RTX 5090: 8,4 ГБ у дистиллированной 4B и 9,2 ГБ у базовой, 19,6 и 21,7 ГБ у вариантов 9B.
Противоречия нет. Карточка описывает загрузку всей схемы сразу, а ComfyUI управляет памятью и подгружает компоненты по очереди. Отсюда практический вывод: требование зависит не только от модели, но и от программы. Для покупки лучше ориентироваться на большую цифру, а меньшую считать тем, к чему можно прийти оптимизацией.
Из чего складывается расход памяти
Файл модели, который вы скачиваете, это только часть того, что окажется в VRAM. Любая современная схема генерации состоит минимум из трёх звеньев, и каждое занимает место.
- Текстовый энкодер переводит ваш запрос в числа, понятные модели. У SD 1.5 он небольшой, а у новых моделей это полноценная нейросеть: в SD 3.5 работают сразу три энкодера, у FLUX.2 [klein] 9B языковая модель на 8 млрд параметров.
- Диффузионная модель за несколько десятков или всего за несколько шагов строит изображение в сжатом виде. Именно её размер указывают в названии: 4B, 9B и так далее. Это миллиарды параметров, а не гигабайты.
- VAE превращает сжатое представление в обычную картинку с пикселями.
Сверху добавляются промежуточные данные каждого шага. Их объём зависит от разрешения и числа изображений за проход: веса модели остаются прежними, а рабочий буфер растёт вместе с кадром. Поэтому схема, спокойно работающая в 1024 × 1024, при попытке сразу получить 2048 × 2048 может упереться в потолок памяти.
Как уложиться в меньший объём
Если памяти не хватает совсем немного, есть несколько рычагов. Применяйте их по одному, чтобы видеть эффект.
- Батч 1. Генерировать по одной картинке и ставить запуски в очередь, а не считать десять изображений за проход.
- Базовое разрешение. Генерировать в родном размере модели, а увеличение делать отдельным этапом.
- Компактный формат весов. FP8 вдвое короче FP16 и BF16 на хранение, 4-битные варианты ещё меньше. Качество лиц, текста и мелких деталей при этом проверяйте на своих запросах.
- Программа с умной выгрузкой. Разработчики ComfyUI заявляют, что благодаря распределению памяти между VRAM и RAM даже крупные открытые модели запускаются на 4 ГБ видеопамяти и 8 ГБ оперативной. Медленно, но запускаются.
- Отключить лишние модули. ControlNet, IP-Adapter, refiner и апскейл добавляют собственные модели, и каждая занимает место.
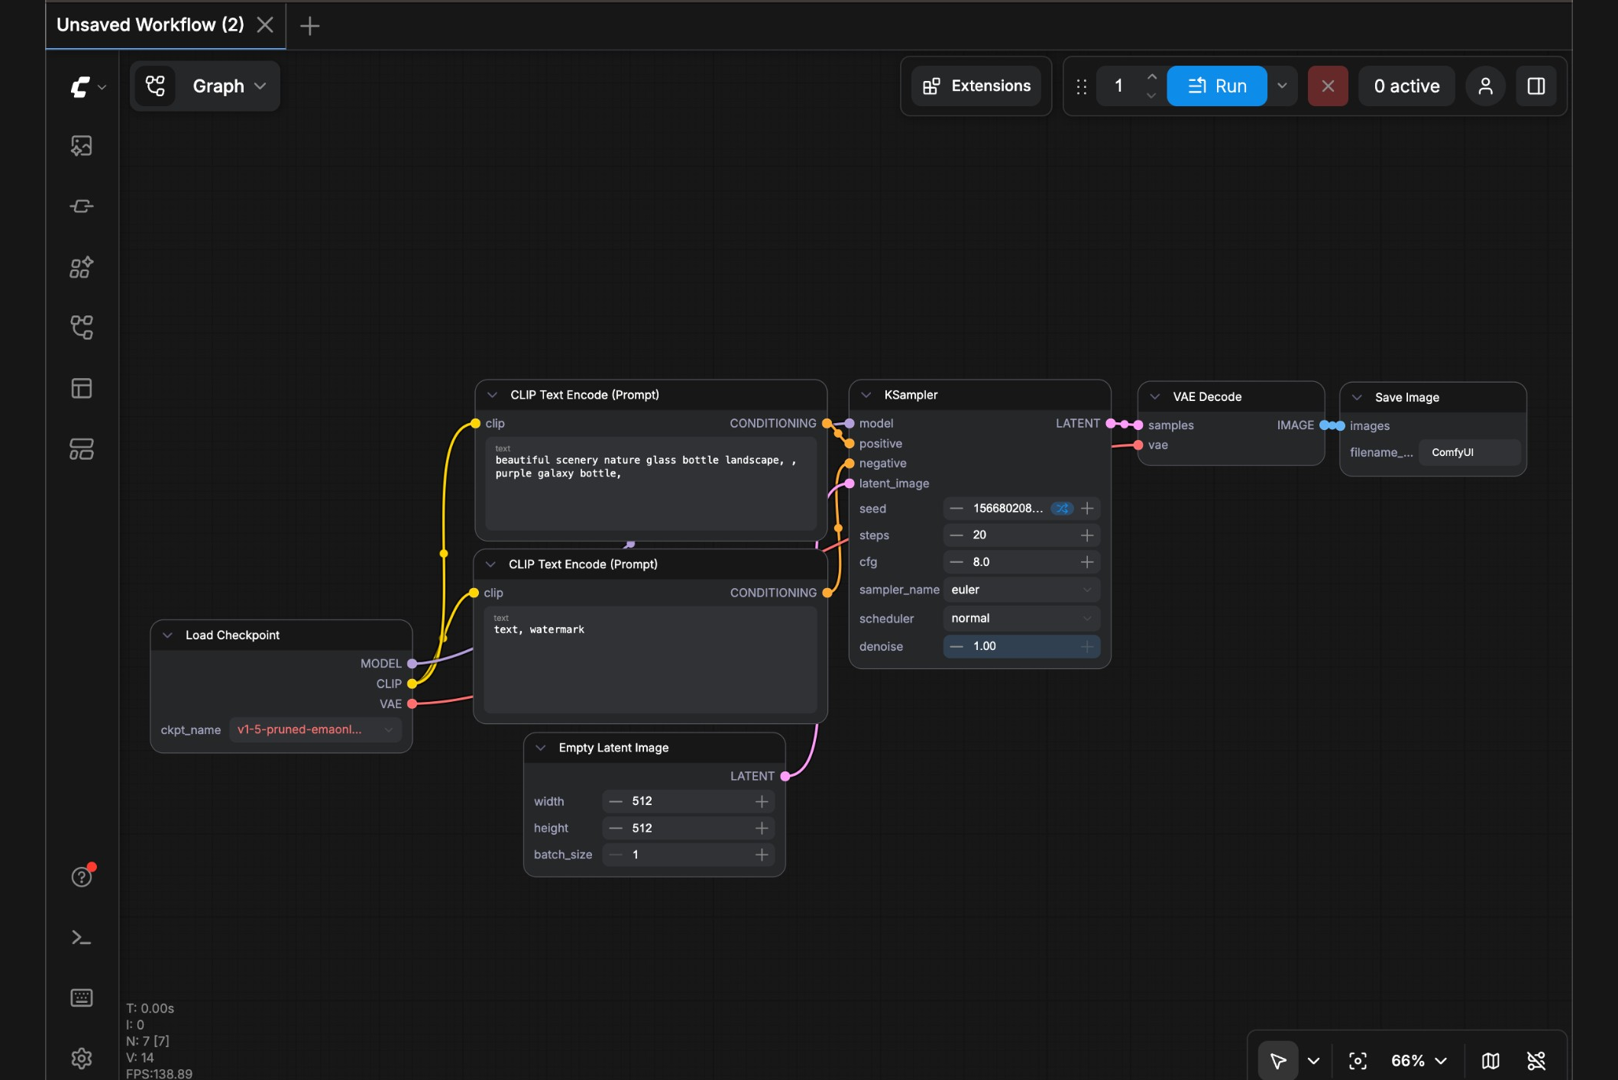
ComfyUI работает с видеокартами NVIDIA, AMD (через ROCm, архитектуры от RDNA 2 до RDNA 4), Intel Arc и с Apple Silicon. В списке поддерживаемых моделей SD 1.5, SDXL, SD 3.5, FLUX.1 и FLUX.2.
Если решили обновить компьютер
Для генерации изображений объём видеопамяти важнее, чем для игр. Вместе с видеокартой посмотрите на оперативную память: при выгрузке именно она принимает компоненты, которые не поместились на GPU. Быстрый NVMe SSD сократит загрузку моделей, которые весят десятки гигабайт.
Готовые варианты удобно подобрать в каталоге HYPERPC, а точную конфигурацию с нужной видеокартой настроить в конфигураторе. Если генерация изображений лишь часть задач и нужна карта для обучения моделей, читайте наш разбор выбора видеокарты для машинного обучения.
Часто задаваемые вопросы Мы подготовили ответы.
-
Пойдёт ли SDXL на видеокарте с 8 ГБ?
Да, Stability AI называла 8 ГБ рабочим объёмом для SDXL. Для одной картинки 1024 × 1024 без дополнений этого хватает.
-
Сколько памяти нужно для FLUX.2 [klein] 4B?
Разработчик указывает около 13 ГБ. В замерах ComfyUI на RTX 5090 расход был 8,4-9,2 ГБ. Карта на 16 ГБ закрывает задачу с запасом.
-
Можно ли запустить SD 3.5 Large на 12 ГБ?
Только в FP8-версии через TensorRT, которой по данным NVIDIA нужно около 11 ГБ, и только на RTX 40 или RTX 50.
Рекомендуем